Uji Klinis Chatbot Medis Google AMIE Ubah Praktik Dokter
ORBITINDONESIA.COM – Uji klinis chatbot medis Google AMIE di Beth Israel Deaconess Medical Center, Boston, menunjukkan A.I. dapat membantu dokter layanan primer tanpa banyak “halusinasi”. Dalam studi yang dimuat di The Lancet, dokter menilai bot ini membantu sekitar 75 persen kasus dan memengaruhi cara penanganan pada lebih dari separuh kasus.
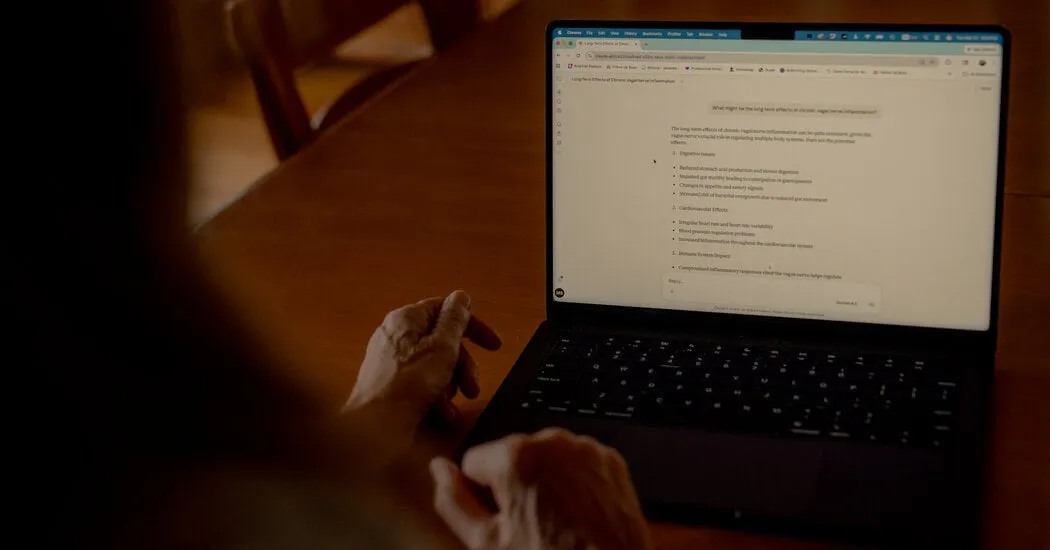
Selama delapan bulan, hampir 100 pasien yang menjadwalkan kunjungan ke fasilitas urgent care diminta berbicara lebih dulu dengan chatbot Google sebelum bertemu dokter. Bot itu menggali gejala, kemungkinan penyebab, dan opsi terapi, lalu membuat ringkasan yang bisa dibaca dokter sebelum konsultasi.
Tujuan utamanya bukan menggantikan dokter, melainkan menguji keamanan dan potensi manfaat klinis tanpa informasi menyesatkan. Para pasien juga menaruh percaya hanya karena bot bekerja berdampingan dengan dokter terlatih, bukan berdiri sendiri.
Dalam studi “pertama dari jenisnya” menurut laporan tersebut, dokter layanan primer menyebut bot membantu pada sekitar 75 persen kasus, dan teknologinya mungkin mengubah penanganan pada lebih dari setengah kasus itu. Peter Brodeur, residen di Beth Israel, mengatakan dokter membandingkan bot ini dengan “mahasiswa kedokteran atau residen berkinerja tinggi.”
Temuan yang paling sensitif adalah soal “halusinasi” A.I., yakni ketika sistem mengarang informasi. Studi menyebut halusinasi terjadi hanya sekali dari ratusan percakapan, dan bentuknya relatif ringan: bot salah merepresentasikan tanggal, seolah-olah berada di masa depan padahal sudah berlalu.
Namun risiko bukan hanya halusinasi, melainkan juga efek psikologis dan bias interpretasi pada pasien. Karena itu, selama uji coba dokter memantau percakapan dan siap menghentikan bila mengarah ke situasi tak aman, meski tidak ada percakapan yang perlu dihentikan.
Dokter tetap turun tangan pada lima kesempatan untuk memberi konteks tambahan. Dalam satu contoh, bot memasukkan kanker sebagai salah satu kemungkinan diagnosis, lalu dokter masuk untuk menenangkan pasien bahwa bot sedang mempertimbangkan semua kemungkinan.
Konteks industri memperlihatkan mengapa uji klinis semacam ini penting. Investigasi The New York Times sebelumnya menemukan jawaban A.I. di mesin pencari Google tidak akurat sekitar 10 persen, sehingga klaim “lebih aman” pada produk klinis harus diuji dengan disiplin ketat.
Google menegaskan AMIE dilatih khusus untuk “clinical reasoning” dan diagnosis medis, serta ditenagai Gemini versi lebih kuat dibanding yang dipakai pada fitur pencarian. Adam Rodman menyebut model ini bernalar dari percakapan yang relatif singkat, sehingga peluang halusinasi lebih kecil dibanding sistem yang harus memproses seluruh rekam medis pasien.
Di sisi lain, justru “percakapan singkat” bisa menjadi pedang bermata dua. Ringkasan yang rapi dapat menghemat waktu, tetapi juga berisiko menutup nuansa, terutama bila gejala pasien kompleks, bertumpuk, atau dipengaruhi faktor sosial-psikologis yang sulit ditangkap A.I.
Uji coba di Beth Israel dirancang terutama untuk menguji keselamatan, bukan membuktikan efisiensi sistem kesehatan. Google kini memulai uji nasional untuk membandingkan kunjungan pasien dengan dan tanpa chatbot, yang akan lebih relevan untuk menilai dampak pada beban kerja dan mutu layanan.
Robert Califf, kardiolog Duke dan mantan komisioner FDA yang tidak terlibat studi, menyebutnya “teknologi masa depan.” Ia juga mengingatkan kita tidak boleh menganggap otomatis teknologi ini mengurangi beban dokter, karena bisa saja justru membuka masalah baru yang sebelumnya tidak menyita waktu dokter.
Terjemahan akurat dari artikel sumber menunjukkan satu pesan: A.I. klinis bekerja paling aman ketika ia menjadi “asisten”, bukan “otoritas.” Kalimat Rodman, “pasien tidak percaya sampai tahu bot itu menyerahkan ke dokter,” mengungkap kebutuhan publik akan akuntabilitas manusia dalam keputusan medis.
Di ruang praktik, ringkasan chatbot dapat menjadi alat triase pengetahuan yang membantu dokter masuk ke inti masalah lebih cepat. Tetapi bila rumah sakit tergoda menjadikannya pintu masuk tunggal, risiko bergeser dari halusinasi menjadi ketimpangan akses, sebab pasien dengan literasi rendah atau kondisi kompleks bisa tertinggal.
Yang juga patut dicermati adalah standar pembuktian yang kita terapkan. Jika mesin pencari A.I. bisa meleset 10 persen, maka produk klinis harus dinilai dengan metrik lebih keras: keselamatan, dampak psikologis, bias, dan mekanisme audit yang bisa ditelusuri.
Uji di Beth Israel memberi sinyal positif, tetapi skalanya masih kecil dan sangat terkontrol. Pertanyaan besarnya adalah apakah performa “seperti residen unggul” itu bertahan saat dihadapkan pada pasien multikomorbid, tekanan waktu, dan variasi budaya bahasa di luar ruang uji.
Chatbot medis Google AMIE menunjukkan bahwa A.I. bisa membantu dokter menyiapkan konsultasi, mengurangi pekerjaan repetitif, dan memperjelas arah tanya-jawab klinis. Namun studi ini juga menegaskan batasnya: kepercayaan pasien lahir dari fakta bahwa dokter tetap memegang kendali.
Jika masa depan layanan kesehatan memang akan ditemani A.I., maka pertaruhan utamanya bukan sekadar akurasi, melainkan tata kelola. Kita perlu bertanya, siapa yang bertanggung jawab ketika ringkasan yang meyakinkan ternyata keliru, dan apakah sistem kesehatan siap menempatkan manusia tetap sebagai pagar terakhir keselamatan.
(Orbit dari berbagai sumber, 11 Oktober 2026)





